Hay un capítulo de Los Simpson, King-Size Homer, que hoy resulta incómodamente familiar.
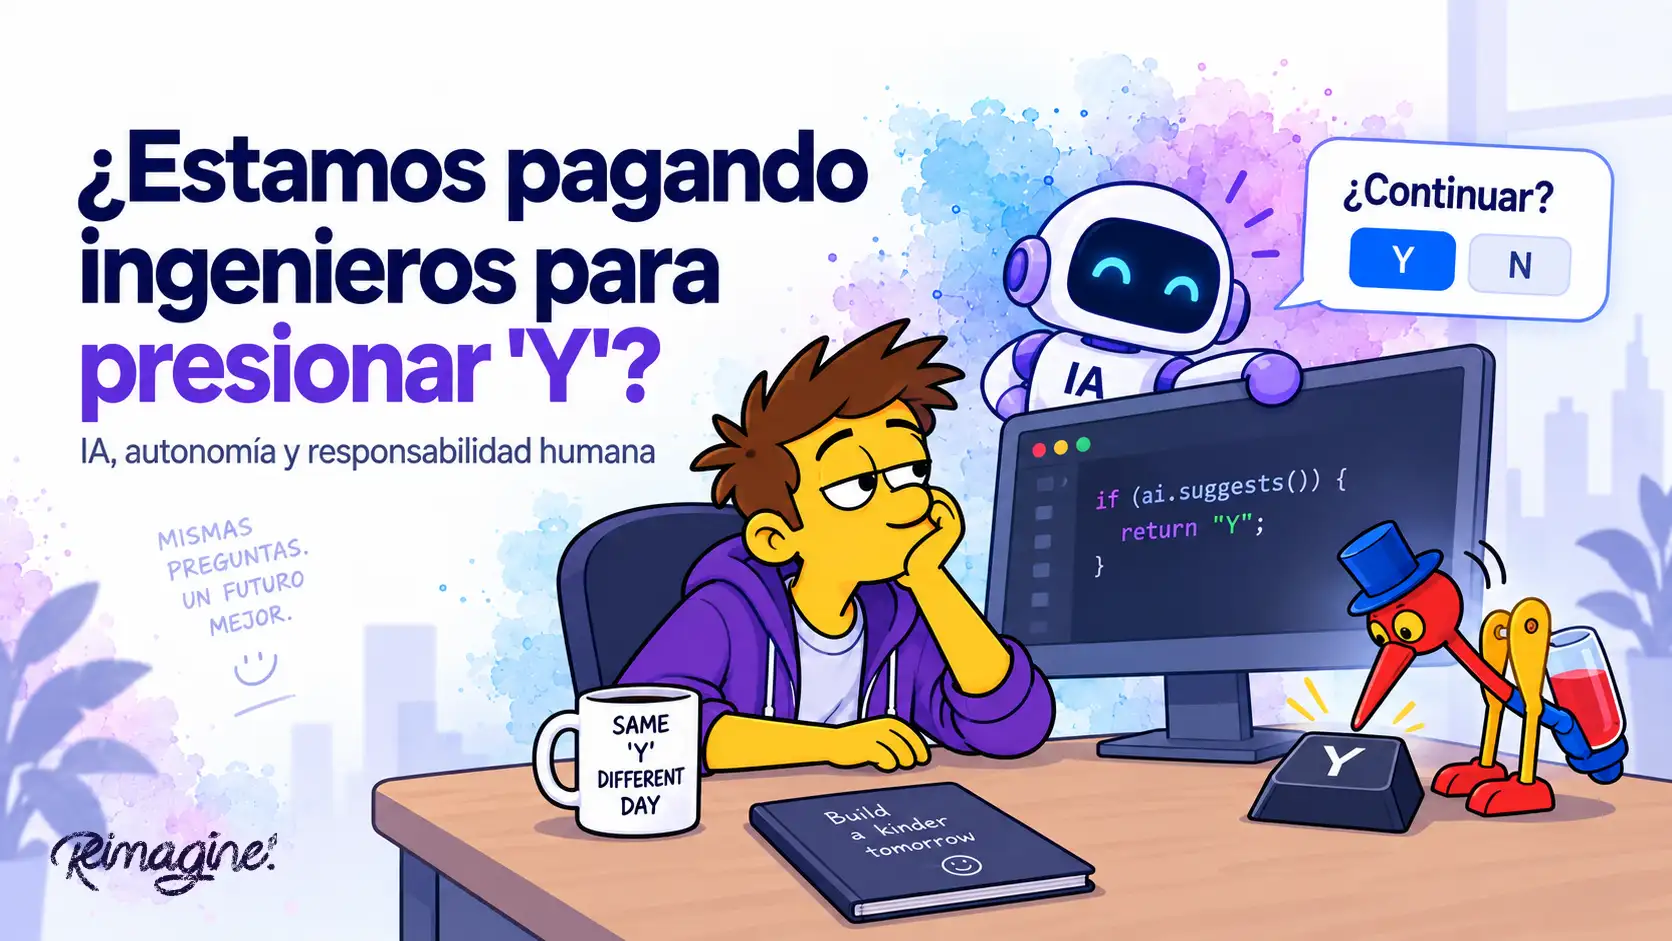
Homero empieza a trabajar desde casa y descubre que buena parte de su trabajo consiste en estar frente a un computador presionando repetidamente la tecla Y.
Para Homero, el descubrimiento es fantástico: ha encontrado un trabajo que puede hacer prácticamente sin pensar.
Y entonces encuentra una forma de hacerlo todavía más eficiente: descubre que ni siquiera necesita estar ahí.
Pone uno de esos pájaros bebedores frente al teclado y deja que presione Y por él mientras sale de casa.
El pájaro sigue aprobando.
Hasta que deja de hacerlo.
Tres décadas después, es difícil no recordar esa escena cuando vemos cómo algunos equipos están adoptando agentes de inteligencia artificial:
El agente quiere ejecutar este comando. ¿Permitir?
Sí.
El agente quiere modificar estos archivos. ¿Permitir?
Sí.
El agente quiere instalar esta dependencia. ¿Permitir?
Sí.
¿Desea continuar?
Sí.
En algún momento vale la pena hacernos una pregunta incómoda:
¿Estamos pagando ingenieros de software para convertirse en el pájaro de Homero?
El problema no es delegarle trabajo a la IA. Para eso está.
De hecho, deberíamos usarla. Y probablemente deberíamos usarla mucho más.
Yo mismo utilizo estas herramientas todos los días. Pueden explorar repositorios, entender dependencias, proponer soluciones, escribir código, generar pruebas, investigar fallas, hacer refactors y ejecutar en minutos trabajos que antes tomaban horas.
El problema empieza cuando, junto con el trabajo, empezamos a delegarles también el criterio.
El botón de aprobación más caro de la compañía
Imaginemos una historia relativamente normal.
Un desarrollador recibe una nueva funcionalidad. Le entrega el requerimiento a un agente.
El agente explora el repositorio, identifica los componentes involucrados, propone un plan, modifica varios archivos, crea pruebas, encuentra errores, los corrige y vuelve a ejecutar la suite.
Todo queda en verde.
El agente genera un resumen.
El desarrollador revisa rápidamente el resultado, aprueba un par de acciones y abre el pull request.
Visto desde afuera, parece perfecto.
Algo que podría haber tomado dos días ahora toma dos horas.
Pero hagamos algunas preguntas.
¿Por qué modificamos esos componentes?
¿Por qué escogimos ese diseño?
¿Qué otras alternativas existían?
¿Qué supuestos tiene la implementación?
¿Qué podría fallar?
¿Qué demostraron realmente las pruebas?
¿Cómo afecta este cambio al resto del sistema?
Si quien desarrolló la funcionalidad no puede responder con claridad porque, en la práctica, “eso lo hizo el agente”, tenemos un problema.
No creamos un ingeniero 10x.
Tal vez creamos el botón de aprobación más caro de la compañía.
Y eso no es culpa del agente.
Mientras el agente aprende el sistema, el equipo puede dejar de hacerlo
Antes de los agentes, entrar a un sistema que no conocíamos obligaba a hacer cierto recorrido.
Buscar en el repositorio. Leer código. Seguir dependencias. Entender por dónde viajaban los datos. Encontrar decisiones que parecían extrañas hasta descubrir por qué existían.
No era necesariamente eficiente. Tampoco garantizaba que todos entendieran perfectamente el producto.
Pero había una consecuencia importante: para modificar el sistema, normalmente teníamos que adquirir algo de contexto sobre él.
Con un agente, esa relación puede cambiar.
El agente lee el repositorio.
El agente sigue las dependencias.
El agente construye el contexto.
El agente hace el cambio.
Y el humano puede limitarse a esperar el resultado.
La paradoja es evidente:
Mientras el agente adquiere contexto sobre el sistema, el equipo puede estar perdiéndolo.
Sabemos hablar de deuda técnica. Tenemos herramientas para encontrar vulnerabilidades, complejidad, problemas de dependencias y baja cobertura.
Pero ¿qué dashboard le dice a un CTO que las personas responsables de un producto están dejando gradualmente de entender cómo funciona?
El código puede compilar.
Los tests pueden pasar.
El velocity puede subir.
Y aun así, seis meses después, podemos terminar con un equipo que ha hecho cientos de cambios sobre un producto que ya nadie puede explicar con suficiente seguridad.
Podríamos llamarlo deuda de comprensión.
Y, a diferencia de muchas formas de deuda técnica, puede crecer en silencio.
Hasta que producción nos obliga a pagarla.
No puedes tener ownership sobre algo que no entiendes
Para mí, aquí está uno de los principios fundamentales de la ingeniería asistida por IA:
Podemos delegar la ejecución. No podemos delegar la responsabilidad.
Un desarrollador puede delegar la escritura de código.
Un arquitecto puede pedirle a un agente que explore alternativas.
QA puede usar IA para generar escenarios y buscar casos borde.
Producto puede utilizarla para analizar requerimientos.
Un CTO puede apoyarse en un agente para cuestionar una arquitectura, investigar un incidente o evaluar una decisión técnica.
Nada de eso reduce la responsabilidad profesional de quien toma la decisión.
Cuando producción falla, “eso fue lo que hizo el agente” no es una respuesta.
Alguien aceptó ese cambio.
Alguien permitió que llegara a producción.
Alguien debe poder explicar por qué.
El verdadero ownership exige comprensión.
No podemos aprobar seriamente algo que no entendemos ni defender una decisión que nunca evaluamos.
Estar “human in the loop” no significa estar en control
Muchas estrategias de adopción de IA incluyen una frase tranquilizadora: siempre habrá un human in the loop.
Bien.
Pero un humano presionando Allow también está técnicamente dentro del loop.
Homero estaba dentro del loop.
La presencia humana, por sí sola, no es un control. El criterio humano sí.
Y esta diferencia va a ser cada vez más importante.
Los agentes van a tener más autonomía. Podrán investigar, modificar código, ejecutar pruebas, crear pull requests y completar flujos cada vez más largos sin intervención constante.
Responder a eso agregando una aprobación manual cada treinta segundos no es gobierno.
Es convertir al ingeniero en el pájaro.
Más autonomía no debería significar menos responsabilidad. Debería exigir mayor madurez alrededor de esa autonomía: mejores límites, verificación, observabilidad, controles y ownership.
Ya aprendimos algo parecido con CI/CD, infraestructura como código y automatización operacional.
Automatizar una operación nunca eliminó la responsabilidad sobre ella.
La IA tampoco va a eliminar la responsabilidad de ingeniería.
El rol del ingeniero tiene que evolucionar
Hay una conversación que quizá resulte todavía más incómoda.
Si los agentes pueden escribir más código, más rápido y con resultados cada vez mejores, el valor de simplemente transformar un requerimiento en sintaxis inevitablemente va a disminuir.
Eso no vuelve irrelevante al ingeniero de software.
Mueve su valor.
Hacia entender el problema de negocio.
Cuestionar un requerimiento.
Diseñar sistemas y evaluar trade-offs.
Detectar una mala solución aunque compile.
Pensar en seguridad, fallas y mantenibilidad.
Y, sobre todo, poder responder por las decisiones que llegan a producción.
La IA disminuye el valor relativo de producir código y aumenta el valor relativo de ejercer criterio de ingeniería.
Eso debería ser una buena noticia.
Nos permite sacar al ingeniero de parte del trabajo mecánico para concentrarlo en actividades de mayor valor.
Pero la organización tiene que redefinir qué espera de él.
Cambian los roles.
Cambian las responsabilidades.
Cambian los procesos de revisión.
Cambia la forma de formar juniors.
Cambia el trabajo de tech leads y arquitectos.
Y también tiene que cambiar la forma en que medimos productividad.
Cuidado con celebrar demasiado pronto la “productividad”
Es fácil decir:
“Tenemos que usar IA.”
“Necesitamos más velocity.”
“¿Por qué esta historia todavía tarda tres días?”
“¿Cuánto código estamos generando?”
“¿Cuántos PR adicionales estamos produciendo?”
Y después sorprendernos cuando el equipo descubre que la forma más sencilla de mejorar esos números es dejar que el agente haga cada vez más y revisar cada vez menos.
Las personas optimizan el sistema que construimos alrededor de ellas.
Si premiamos output, la IA nos va a dar cantidades extraordinarias de output.
Más código.
Más commits.
Más pull requests.
Más tickets cerrados.
Pero ninguna compañía crea valor porque su repositorio creció más rápido.
La pregunta debería ser otra:
¿Estamos entregando más valor de negocio, más rápido, sin aumentar el riesgo ni perder el control del sistema?
Entonces importan otras cosas: defectos, retrabajo, seguridad, mantenibilidad, estabilidad, tiempo de recuperación y cuánto conocimiento conserva el equipo sobre el producto que opera.
Un equipo que entrega el doble de rápido pero entiende la mitad de su sistema puede mostrar excelentes cifras de productividad mientras construye un problema para el futuro.
Tal vez no estamos ganando productividad.
Tal vez la estamos pidiendo prestada.
Tu organización probablemente ya adoptó IA
La discusión sobre si los equipos de desarrollo deberían utilizar inteligencia artificial ya quedó atrás.
La están utilizando.
De manera oficial o no.
Con herramientas aprobadas por la compañía o con cuentas propias.
Para escribir código, investigar incidentes, crear pruebas, entender repositorios, documentar y diseñar soluciones.
La pregunta interesante ya no es si la IA entrará al ciclo de desarrollo.
Ya entró.
La pregunta es:
¿Tu organización diseñó conscientemente cómo debe utilizarse la IA o su modelo de adopción apareció solo, como resultado de cientos de decisiones individuales?
Son escenarios muy distintos.
Una adopción madura no consiste únicamente en escoger una herramienta ni se resuelve escribiendo una política corporativa.
Nos obliga a responder preguntas más difíciles:
¿Cuánta autonomía puede tener un agente?
¿Qué debe verificar una persona antes de aceptar su trabajo?
¿Cómo sabemos que quien aprueba realmente entiende?
¿Qué decisiones pueden automatizarse y cuáles requieren otro nivel de control?
¿Cómo deben evolucionar los roles?
¿Qué indicadores nos dicen que estamos mejorando y no simplemente produciendo más?
Y quizá la más importante:
¿Cómo aumentamos la autonomía de los agentes sin disminuir la responsabilidad humana?
No todas las organizaciones están preparadas para el mismo nivel de autonomía.
Y ese puede ser uno de los errores más comunes: creer que adoptar una herramienta más poderosa significa automáticamente estar preparado para utilizar toda su capacidad.
La madurez del agente y la madurez de la organización no son la misma cosa.
El Y Test
Hay una prueba sencilla que me gusta porque nos devuelve al punto de partida.
La próxima vez que alguien apruebe una acción propuesta por un agente, quitemos mentalmente al agente de la conversación y hagamos una pregunta:
¿Puedes explicar qué acabas de aprobar y por qué?
No línea por línea.
No de memoria.
Pero sí con suficiente claridad para defender esa decisión como profesional.
¿Qué cambió?
¿Por qué?
¿Qué consecuencias tiene?
¿Qué puede salir mal?
¿Cómo sabemos que funciona?
Si quien es responsable del cambio no puede responder, probablemente no teníamos un verdadero human in the loop.
Solo teníamos un humano presionando Y.
Los agentes deberían hacer más trabajo.
Mucho más.
Ahí está buena parte de la oportunidad.
El futuro de la ingeniería de software no puede seguir dependiendo de humanos escribiendo manualmente cada línea de código.
Pero tampoco debería convertirse en humanos aprobando ciegamente cada línea que escriben las máquinas.
Las organizaciones que hagan bien esta transición serán capaces de delegar cada vez más ejecución sin entregar con ella la comprensión, el criterio y la responsabilidad.
Porque la ventaja competitiva probablemente no estará en tener acceso al mejor agente.
El acceso a agentes extraordinariamente capaces pronto dejará de ser un diferenciador.
La diferencia estará en algo menos visible:
qué tan preparada está la organización para utilizarlos.
Tal vez la siguiente conversación sobre adopción de IA no debería empezar preguntando:
“¿Qué agente deberíamos comprar?”
Tal vez debería comenzar con algo más incómodo:
¿Quién está presionando Y, y sabe realmente por qué?